KI-Assistenten schreiben E-Mail-Entwürfe, fassen Berichte zusammen und helfen bei der Softwareentwicklung. Für Unternehmen stellt sich damit eine praktische Frage: Welches Werkzeug passt zur Aufgabe, und welche Daten dürfen darin verarbeitet werden? Ein Blick auf die Geschichte erklärt, wie KI im Arbeitsalltag angekommen ist. Der anschließende Vergleich hilft Ihnen, Einsatzmöglichkeiten, Betriebsformen und Datenschutzanforderungen einzuordnen.
Ein kurzer Blick zurück: Woher die KI kommt#
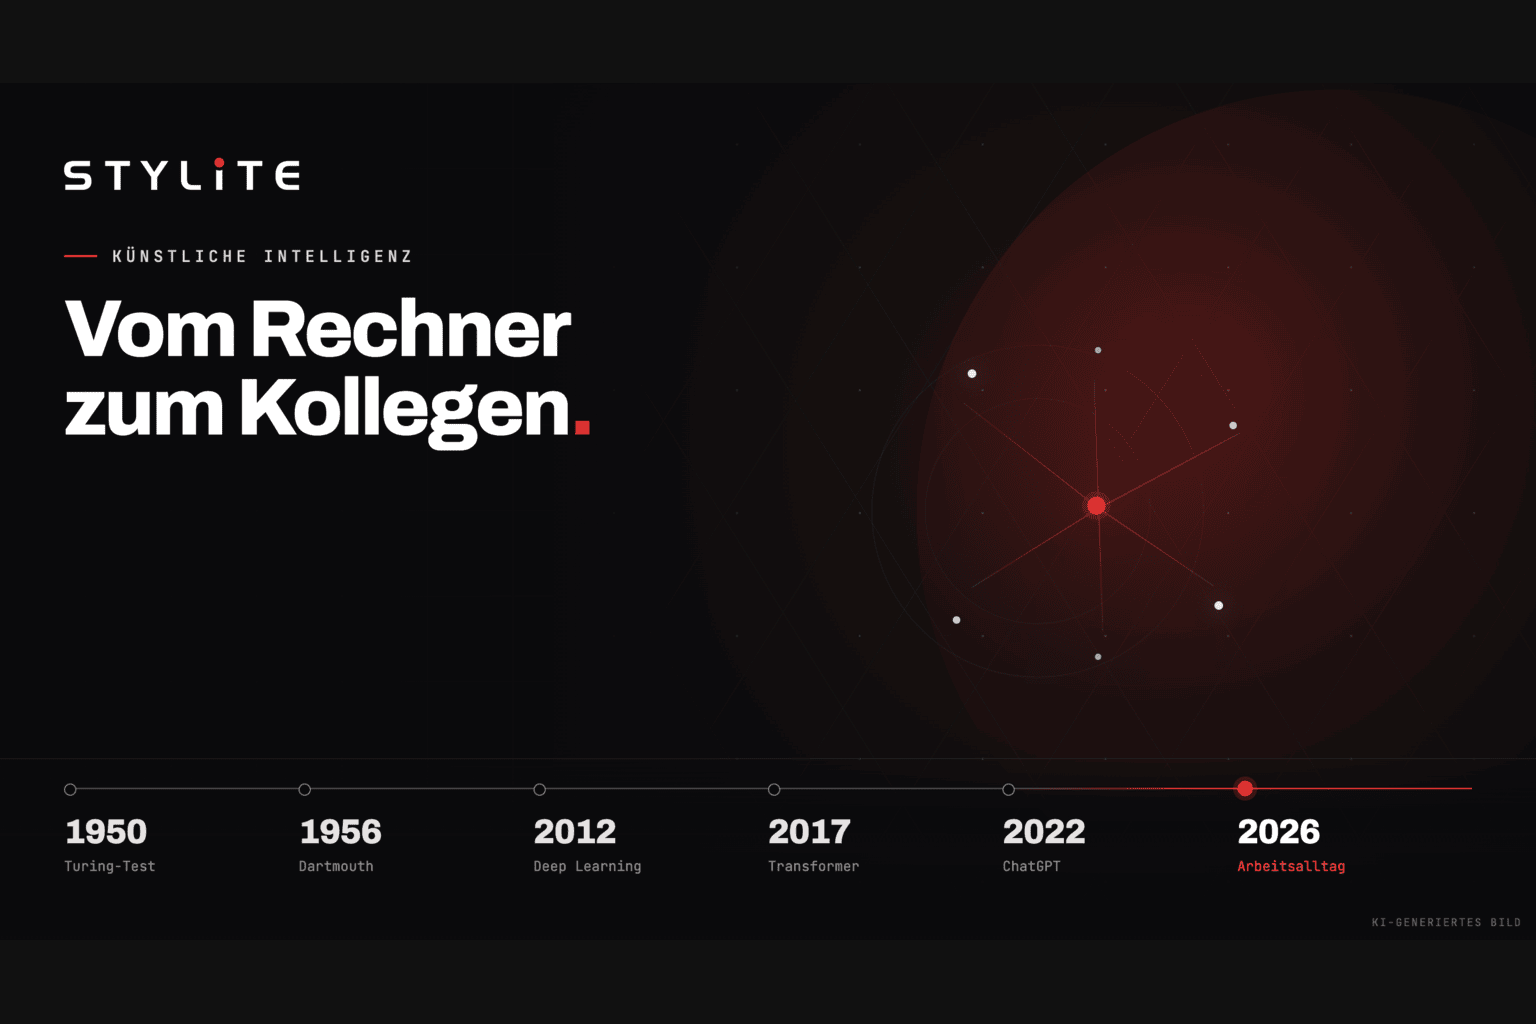
Die Vorstellung denkender Maschinen ist älter als jedes Smartphone. Einen wissenschaftlichen Ausgangspunkt lieferte Alan Turing 1950 mit seinem Aufsatz „Computing Machinery and Intelligence“. Darin beschrieb er das später als Turing-Test bekannte Imitationsspiel. 1956 versammelten sich Forscher zum Dartmouth Summer Research Project. John McCarthy, Marvin Minsky, Nathaniel Rochester und Claude Shannon hatten den Begriff „Artificial Intelligence“ bereits im Projektantrag von 1955 verwendet. Das Treffen gilt als Ausgangspunkt der KI als eigenständigem Forschungsfeld.
Von der Idee zur Ernüchterung#
Auf die Aufbruchsstimmung folgten Jahrzehnte des Auf und Ab. Viele Erwartungen an KI-Systeme erfüllten sich nicht. In den sogenannten „KI-Wintern“ gingen Interesse und Finanzierung zurück. Die Grundlagenforschung lief weiter. Für spätere Fortschritte bei neuronalen Netzen waren neben leistungsfähigerer Hardware auch bessere Trainingsverfahren und größere Datenbestände entscheidend.
Der Durchbruch des Deep Learnings#
Grafikprozessoren (GPUs) machten das Training großer neuronaler Netze praktikabler. 2012 gewann AlexNet den ImageNet-Wettbewerb zur Bilderkennung mit deutlichem Vorsprung. Die Forscher beschrieben ihre Methode in „ImageNet Classification with Deep Convolutional Neural Networks“ . 2017 folgte die Transformer-Architektur aus „Attention Is All You Need“ , auf der viele heutige Sprachmodelle aufbauen.
Warum es plötzlich so schnell ging#
Mit der öffentlichen Freigabe von ChatGPT am 30. November 2022 erreichten solche Sprachmodelle ein breites Publikum. Menschen konnten sie über eine Chat-Oberfläche ausprobieren und in natürlicher Sprache bedienen.
Dahinter standen Fortschritte bei Rechenleistung, Trainingsverfahren und der Nutzung großer Datenbestände. Die leicht zugängliche Oberfläche senkte die Einstiegshürde: Für einen Textentwurf oder die Erklärung eines Fachbegriffs brauchte es keine Programmierkenntnisse mehr.
Wo KI heute schon arbeitet#
KI umfasst mehr als generative Chat-Assistenten. Auch spezialisierte Systeme zur Mustererkennung gehören dazu. Die folgenden Beispiele beziehen sich deshalb auf unterschiedliche Arten von KI:
- Text und Kommunikation: Entwürfe für E-Mails, Angebote und Dokumentationen, Zusammenfassungen langer Berichte, Übersetzungen in Echtzeit.
- Softwareentwicklung: Code-Vervollständigung, Fehlersuche und Erklärung fremder Codebasen – ein Bereich, in dem KI-Assistenten inzwischen fester Bestandteil vieler Entwicklerteams sind.
- Kundenservice: Chatbots und Assistenzsysteme, die Standardanfragen beantworten und komplexe Fälle vorstrukturiert an Mitarbeiter übergeben.
- Medizin und Diagnostik: Spezialisierte medizinische KI-Systeme unterstützen etwa die Auswertung bildgebender Verfahren. Beispiele dokumentiert die FDA in ihrer Übersicht KI-gestützter Medizinprodukte . Daraus lässt sich keine Eignung allgemeiner Chat-Assistenten für die Diagnostik ableiten.
- IT-Sicherheit: Erkennung von Anomalien im Netzwerkverkehr, Einordnung von Bedrohungen und Unterstützung bei der Analyse von Sicherheitsvorfällen.
- Wissensarbeit allgemein: Recherche mit Quellenangabe, Datenanalyse und die Aufbereitung von Informationen aus großen, unstrukturierten Beständen.
Bei diesen Aufgaben bleiben Menschen für die Ergebnisse verantwortlich. Sprachmodelle können Fakten, Quellen und Zusammenhänge falsch wiedergeben. Prüfen Sie deshalb insbesondere Aussagen, die Sie gegenüber Kunden verwenden, und Code, den Sie produktiv einsetzen möchten.
Wo KI in den kommenden Jahren wachsen wird#
Für den Arbeitsalltag erscheinen vor allem die folgenden Entwicklungsrichtungen relevant. Wie stark sie sich durchsetzen, hängt auch von Zuverlässigkeit, Betriebskosten und der Einbindung in bestehende Prozesse ab.
- Agentische KI: Systeme, die nicht nur antworten, sondern eigenständig mehrstufige Aufgaben ausführen – Termine koordinieren, Daten aus verschiedenen Quellen zusammenführen, Prozesse anstoßen. Das verlagert den Nutzen von „Frage und Antwort“ hin zu „Auftrag und Erledigung“.
- Branchenspezifische Modelle: Statt eines Alleskönners rücken spezialisierte Modelle für Recht, Medizin oder Ingenieurwesen in den Vordergrund, die mit domänenspezifischem Wissen trainiert sind.
- KI vor Ort statt in der Cloud: Kleinere, effizientere Modelle laufen zunehmend auf eigener Hardware. Für Unternehmen mit hohen Datenschutzanforderungen ist das ein entscheidender Hebel – dazu weiter unten mehr.
- Multimodalität: Die gemeinsame Verarbeitung von Text, Bild, Audio und Video eröffnet Anwendungsfelder, etwa in der Fertigung oder im Support.
- Integration in bestehende Software: KI-Funktionen in vorhandenen Werkzeugen, etwa Office-Paketen, können zusätzliche Einsatzmöglichkeiten eröffnen. Wie viel Arbeit sie abnehmen, hängt vom jeweiligen Prozess ab.
Der Werkzeugkasten: KI-Assistenten im Vergleich#
Für den Unternehmenseinsatz lohnt es sich, zwischen fertigen Chat-Assistenten, APIs für eigene Anwendungen und Modellen für den Selbstbetrieb zu unterscheiden. Sie lösen unterschiedliche Aufgaben und bringen unterschiedliche Anforderungen an Betrieb und Datenschutz mit.
Stand: 14. September 2026. Die Tabelle dient der grundsätzlichen Einordnung. Funktionsumfang, regionale Verfügbarkeit und Vertragsbedingungen hängen vom gewählten Produkt und Tarif ab. Ein EU-Standort allein belegt keine DSGVO-Konformität.
Die Vergleichsmatrix#
| Werkzeug / Anbieter | Typische Einsatzgebiete | Betriebsform und Datenschutzprüfung |
|---|---|---|
| ChatGPT / OpenAI | Textarbeit, Analyse, Programmierung | Gehosteter Assistent; separate API für eigene Anwendungen. Für berechtigte Enterprise-/Edu-Kunden gibt es europäische Daten- und Inferenzresidenz (EWR und Schweiz) mit definiertem Geltungsbereich. Datenresidenz |
| Claude / Anthropic | Dokumentenanalyse, Textarbeit, Coding | Gehosteter Assistent und API; Claude-Modelle auch über Amazon Bedrock. Dort hängen Verarbeitungsorte vom Modell und dem regionalen, EU- oder globalen Inferenzprofil ab. Bedrock-Dokumentation |
| Gemini / Google | Multimodale Aufgaben und Arbeit im Google-Umfeld | Gemini-App, Workspace-Integration und Entwicklerangebote unterscheiden. Enterprise Plus und Frontline Plus unterstützen regionale Speicherung und Verarbeitung der Gemini-App; Education Plus und Education Standard nur regionale Speicherung. Google zu Datenregionen |
| Microsoft 365 Copilot | Arbeit mit Office-Dokumenten und Unternehmensinformationen | Dienst im Microsoft-365-Umfeld. Produktbedingungen zu Datenresidenz sowie zusätzlich eingebundene Dienste prüfen. Microsoft-Produktbedingungen |
| Perplexity | Webrecherche mit Quellenverweisen | Gehosteter Rechercheassistent. Private Konten, Enterprise und API unterliegen unterschiedlichen Datenschutzbedingungen; Quellen müssen inhaltlich geprüft werden. Datenschutzhinweise |
| Le Chat / Mistral AI | Allgemeine Assistenz und unternehmensinterne Anwendungen | Französischer Anbieter mit gehostetem Assistenten und Enterprise-Optionen für eine eigene Umgebung. Produktbedingungen und Lizenz des jeweils gewählten Modells getrennt prüfen. Le Chat |
| Aleph Alpha | KI-Anwendungen in Unternehmen und Verwaltung | Deutscher Anbieter mit Fokus auf souveräne Unternehmenslösungen. Betriebsmodell, Integrationsumfang und Datenflüsse projektbezogen prüfen. Anbieterinformationen |
| DeepSeek-Modelle | Basis für eigene KI-Anwendungen | Verfügbare Modellgewichte ermöglichen Eigenbetrieb; Lizenz und Hardwarebedarf hängen vom Modell ab. Gehosteter Chat und API sind davon getrennte Angebote. Modell-Repository |
| Llama / Meta | Basis für Eigenbetrieb und Anpassung | Verfügbare Modellgewichte unter eigener Community-Lizenz. Keine pauschale Open-Source-Freigabe; für den Eigenbetrieb multimodaler Llama-4-Modelle gelten EU-Einschränkungen. Endnutzer integrierter Produkte oder Dienste sind von dieser Einschränkung ausgenommen. Lizenz , Nutzungsbedingungen |
Wie die Matrix zu lesen ist#
Für Textarbeit, Recherche oder Coding sollten Sie die infrage kommenden Assistenten mit denselben Aufgaben aus Ihrem Betrieb testen. Vergleichen Sie die Qualität der Antworten, den Aufwand für Korrekturen und die Integration in Ihre vorhandene Software. Bei Rechercheaufgaben zählt auch, ob die verlinkte Quelle die jeweilige Aussage tatsächlich belegt.
Für den Eigenbetrieb kommen Modelle mit verfügbaren Gewichten infrage, etwa bestimmte Mistral-, DeepSeek- oder Llama-Varianten. Offene Gewichte sind nicht gleich Open Source: Nutzungsrechte, Einschränkungen und die Verfügbarkeit weiterer Bestandteile müssen für das konkrete Modell geprüft werden. Neben Hardware benötigen Sie Personal für Updates, Zugriffsschutz und Überwachung.
Europäische Anbieter oder eigene Infrastruktur können Ihnen mehr Kontrolle über Datenflüsse geben. Entscheidend bleibt, welche Informationen die Anwendung an externe Suchdienste, Erweiterungen oder andere Schnittstellen weitergibt. Die Wahl sollte sich an Ihren Aufgaben und den nachweisbaren Eigenschaften des Betriebs orientieren.
Der blinde Fleck: Datenschutz und Souveränität#
Beim Datenschutz sollten Sie den gesamten Dienst betrachten: Eingaben, hochgeladene Dokumente, Protokolle, angebundene Datenquellen und die erzeugten Ergebnisse. Ein europäischer Firmensitz oder Serverstandort allein beantwortet weder die Frage nach einer Rechtsgrundlage noch nach zulässigen Zugriffen und Übermittlungen. Der Europäische Datenschutzausschuss betont, dass auch die Anonymität eines KI-Modells im Einzelfall zu beurteilen ist. EDPB-Stellungnahme zu KI-Modellen
Klären Sie vor dem Einsatz mit den zuständigen Datenschutz- und IT-Verantwortlichen:
- Daten und Zweck: Welche Informationen benötigen Mitarbeiter für den Anwendungsfall, und welche dürfen sie eingeben?
- Verträge und Datenflüsse: Welche Vereinbarungen gelten für Auftragsverarbeitung, Unterauftragnehmer, Verarbeitungsorte und mögliche Drittlandübermittlungen?
- Speicherung und Training: Wie lange bleiben Eingaben und Ergebnisse gespeichert, wer kann darauf zugreifen, und verwendet der Anbieter sie zum Modelltraining?
- Berechtigungen und Kontrolle: Welche Quellen und Aktionen darf der Assistent nutzen, und wann muss ein Mensch ein Ergebnis oder eine Aktion freigeben?
Hinzu kommt der EU AI Act. Pflichten für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck (GPAI) gelten grundsätzlich seit dem 2. August 2025; für ältere Modelle bestehen Übergangsregelungen. Seit dem 2. August 2026 greifen weitere Durchsetzungsbefugnisse und die Transparenzpflichten nach Artikel 50. Welche Pflichten Ihr Unternehmen treffen, hängt von Ihrer Rolle als Anbieter oder Betreiber und vom konkreten Einsatz ab. Die Regeln für GPAI-Anbieter lassen sich nicht pauschal auf jeden Betrieb übertragen, der einen Chat-Assistenten nutzt. EU-Kommission zum AI Act , Transparenzpflichten
Der Eigenbetrieb kann die Kontrolle über Verarbeitung und Zugriffe stärken. Dafür müssen Sie auch Protokollierung, Backups, Telemetrie und externe Verbindungen beherrschen. Bei Stylite beschäftigen wir uns mit technologieoffenen, datenschutzfreundlichen Lösungen, die Unternehmen diese Kontrolle ermöglichen. Mehr zum Hintergrund lesen Sie in unserem Beitrag über digitale Souveränität durch Open Source .
Fazit: KI mit klaren Aufgaben einsetzen#
Vom Turing-Test bis zum Chat-Assistenten haben Forscher über Jahrzehnte an den Grundlagen gearbeitet. Für Ihren Betrieb zählt heute, bei welchen konkreten Aufgaben die Werkzeuge verlässliche Unterstützung bieten.
Beginnen Sie mit einem abgegrenzten Anwendungsfall und geeigneten, freigegebenen Daten. Vergleichen Sie Ergebnisse und Korrekturaufwand, bevor Sie den Einsatz ausweiten. Legen Sie dabei fest, wer für Freigaben, Datenzugriffe und den Betrieb verantwortlich ist. So können Sie den Nutzen beurteilen und behalten die Kontrolle über Ihre Informationen.
Matteo Keller ist im Marketing bei Stylite AG tätig und beschäftigt sich schwerpunktmäßig mit innovativen, datenschutzfreundlichen Open-Source-Lösungen für Unternehmen.